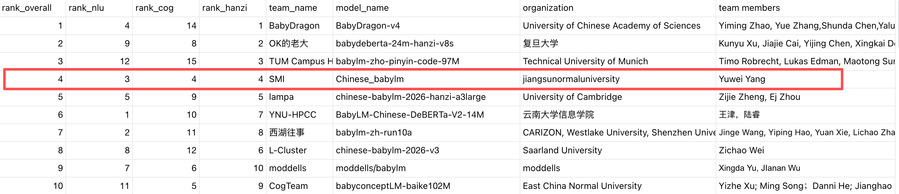
近日,我校语言科学与艺术学院在语言科学赋能人工智能方向取得系列研究进展,参与合作完成的研究论文被AAAI 2026录用,与清华大学合作完成的论文发表于ACL 2026 Findings,另有两篇论文分别被EMNLP 2026 BabyLM Workshop和NLPCC 2026主会录用。团队还在Chinese BabyLM挑战赛中获得综合赛道第4名、自然语言理解赛道第3名。系列成果将语言学的理论方法、语言知识与中文语言资源同大语言模型技术深度融合,并延伸到语言与脑机制对应关系的探索。
在中华优秀语言文化的计算化表达方面,语言科学与艺术学院与清华大学合作完成的研究论文“From Scaffolding to Assimilation: Progressive Structural Internalization for Format-Constrained Creative Text Generation”发表于ACL 2026 Findings。该研究聚焦大语言模型古典诗词创作,提出渐进式结构内化方法,引导模型掌握字数、平仄和押韵规则。在近体诗生成评测中,平仄合规率由10.88%提高至97.80%,押韵合规率由33.00%提高至97.30%,为大模型格律诗词创作提供了新方法。
在语言模型预训练的基础方法层面,团队的研究论文“Learning What Can Combine and What Can Substitute: Relational Inductive Biases for BabyLM Pretraining”被EMNLP 2026的BabyLM Workshop录用。研究将语言学中的组合关系与聚合关系引入预训练,转化为学习目标,探索有限数据条件下的语言规律学习。在1000万词语料条件下,聚合关系方法的平均综合得分由39.76提高至40.19,并在三个随机种子实验中均优于基线,为数据受限的语言建模研究提供了参考。
在中文语言模型方面,团队的论文“Tone Negatives and Conditional Glyph Priors for Sample-Efficient Chinese BabyLM Pretraining”获NLPCC 2026主会录用。研究利用汉字声调和字形信息优化有限数据条件下的中文模型训练。声调负样本使汉字拼音评测得分由47.80提高至58.50,声调易混淆字恢复准确率最高由69.7%提高至96.3%。在同期举行的Chinese BabyLM挑战赛中,团队获得综合赛道第4名、自然语言理解赛道第3名。
在语言与脑机制的交叉研究方面,语言科学与艺术学院参与合作完成的研究论文“Do Large Language Models Think Like the Brain? Sentence-Level Evidences from Layer-Wise Embeddings and fMRI”获AAAI 2026录用。研究以中英文自然叙事语料为材料,采集母语为汉语的健康被试收听中文有声书时的fMRI数据。同时从公开大语言模型中逐层提取句子级表征,构建体素级编码模型,系统考察模型与人类句子理解过程中脑区激活的对应关系。该研究发现,模型类脑表征的形成关键在于语义理解能力而非参数规模。
ACL论文中,语言科学与艺术学院2024级硕士研究生杨于薇、吴晓青为论文第二、三作者,江苏师范大学与清华大学共同署名;EMNLP和NLPCC论文的第一作者为学院2024级硕士研究生杨于薇,第二作者为2026级硕士研究生濮世皓,酆格斐、杨亦鸣为共同通讯作者。AAAI论文由北京邮电大学、山东大学、江苏师范大学、慕尼黑大学、埃尔朗根—纽伦堡大学等单位合作完成,语言科学与艺术学院杨亦鸣教授为共同通讯作者,其博士生葛兴阳为共同第一作者。
据悉,ACL是计算语言学与自然语言处理领域的国际顶级学术会议,属于中国计算机学会(CCF)推荐A类会议,本次合作成果收录于ACL 2026 Findings。EMNLP是自然语言处理领域的重要国际学术会议,属于CCF推荐B类会议,其BabyLM Workshop关注数据高效预训练与认知语言建模,为语言学与人工智能交叉研究提供交流平台。NLPCC是中国计算机学会主办的自然语言处理与中文计算领域重要国际学术会议,属于CCF推荐C类会议,Chinese BabyLM挑战赛关注有限语料条件下的语言学习与理解能力。AAAI是人工智能领域的顶级国际学术会议,属于CCF推荐A类会议。
(一审:朱祖德,二审:吴向裕,三审:叶慧)